Generative AI Là Gì? Những mặt trái và thách thức đạo đức khi AI làm giả hiện thực
Bài viết phát hành:
Cập nhật lần cuối:
Chỉ vài năm trước, ảnh do máy tính vẽ ra còn dễ nhận ra bởi những bàn tay méo mó và khuôn mặt kỳ quặc. Giờ đây, chúng tôi nhiều lần phải nhìn đi nhìn lại một bức ảnh chân dung hoặc một đoạn video ngắn mới dám chắc nó có phải do AI tạo ra hay không. Sự xuất hiện của các công cụ như Midjourney, Stable Diffusion hay Sora đã làm mờ ranh giới giữa thật và giả. Vậy điều gì nằm sau thuật toán giúp máy tính "vẽ" và "quay phim" thuyết phục đến vậy? Bài viết này giải thích từng lớp công nghệ theo cách dễ hiểu nhất.
AI Tạo Sinh (Generative AI) Là Gì?
AI tạo sinh (Generative AI) là nhánh của học máy tập trung vào việc huấn luyện mô hình để tự tạo ra nội dung mới như văn bản, hình ảnh, âm thanh và video, dựa trên những gì chúng đã học từ dữ liệu. Khác với các hệ thống AI truyền thống chủ yếu phân loại hoặc dự đoán dữ liệu có sẵn, AI tạo sinh sinh ra sản phẩm mới.
Khi bạn nhập một câu lệnh (prompt), hệ thống không đi tìm một bức ảnh có sẵn trên mạng rồi cắt dán. Nó tính toán và sắp xếp các điểm ảnh từ một trạng thái ngẫu nhiên để dựng nên một hình ảnh mới. Cần lưu ý rằng một số nghiên cứu cho thấy trong những tình huống nhất định, mô hình vẫn có thể tạo ra kết quả khá giống dữ liệu huấn luyện, nên không thể nói chắc rằng mọi sản phẩm đều hoàn toàn độc bản.
(Xem thêm: Vành Đai Lửa Thái Bình Dương Là Gì? Những Thảm Họa Dọc Vành Đai Lửa)
Mô Hình Khuếch Tán (Diffusion Model) Hoạt Động Như Thế Nào?
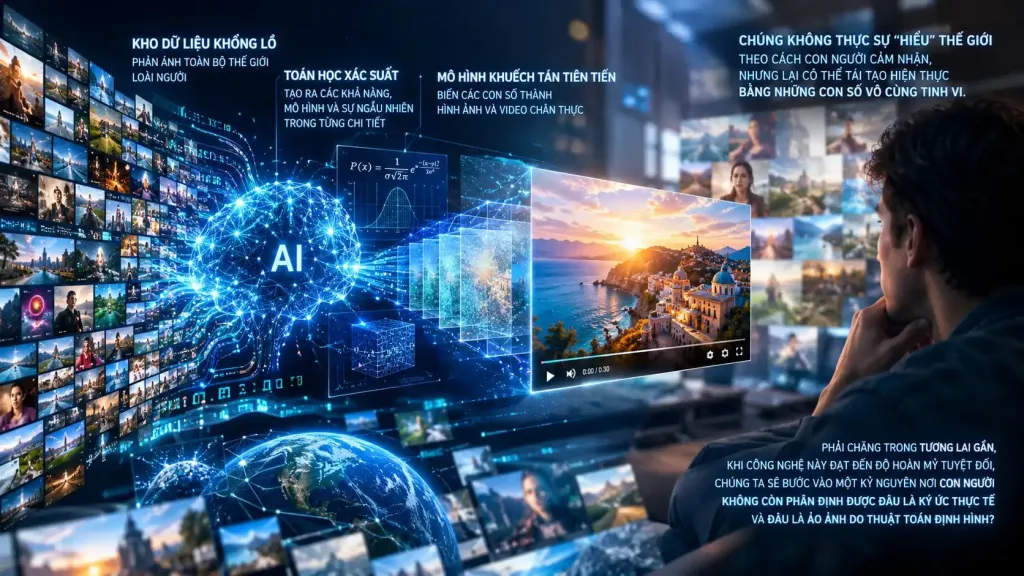
Phần lớn công cụ tạo ảnh và video hiện đại dựa trên mô hình khuếch tán, được làm nổi bật từ công trình về mô hình khuếch tán khử nhiễu của nhóm Jonathan Ho năm 2020. Ý tưởng chính rất dễ hình dung nếu bạn từng thấy màn hình tivi nhiễu hạt.
- Giai đoạn thêm nhiễu (forward process): khi huấn luyện, mô hình lấy rất nhiều ảnh thật và dần dần thêm nhiễu vào cho đến khi ảnh biến thành một màn hình toàn hạt ngẫu nhiên.
- Giai đoạn khử nhiễu (reverse process): mô hình học cách đảo ngược quá trình ấy. Mạng nơ-ron học cách dự đoán và gỡ bớt nhiễu qua từng bước nhỏ, từ khung hình hỗn độn dần hiện ra hình dạng, ánh sáng và chi tiết.
- Dẫn dắt bằng văn bản: câu lệnh của bạn được chuyển thành các con số (vector) để định hướng mô hình ở mỗi bước khử nhiễu. Nhờ vậy, từ cùng một nhiễu ban đầu, các câu lệnh khác nhau cho ra các bức ảnh khác nhau.
Để tiết kiệm sức mạnh tính toán, nhiều mô hình không làm việc trực tiếp trên điểm ảnh mà trên một biểu diễn nén của ảnh, gọi là không gian tiềm ẩn (latent space). Sau khi khử nhiễu xong, một bộ giải mã sẽ chuyển kết quả trở lại thành ảnh nhìn thấy được.
Mạng Đối Kháng Sinh (GAN): Cuộc Đua Giữa Kẻ Làm Giả Và Cảnh Sát
Trước khi mô hình khuếch tán trở nên phổ biến, một kiến trúc khác do Ian Goodfellow và cộng sự đề xuất năm 2014 đã đặt nền móng cho ảnh giả siêu thực, gọi là mạng đối kháng sinh (GAN). Hệ thống này gồm hai mạng nơ-ron cạnh tranh với nhau.
- Mạng tạo sinh (generator): như một kẻ làm giả, tạo ảnh từ dữ liệu ngẫu nhiên để đánh lừa mạng còn lại.
- Mạng phân biệt (discriminator): như một cảnh sát, so sánh ảnh giả với ảnh thật để tìm ra điểm khác biệt.
Qua rất nhiều vòng lặp, kẻ làm giả ngày càng giỏi bắt chước ánh sáng, bóng đổ và kết cấu da, còn cảnh sát cũng ngày càng tinh vi hơn. GAN cho kết quả rất ấn tượng ở nhiều bài toán như khuôn mặt, nhưng quá trình huấn luyện khó ổn định hơn. Đó là một trong những lý do mô hình khuếch tán dần được ưa chuộng hơn cho các công cụ tạo ảnh theo văn bản.
Từ Ảnh Tĩnh Đến Video: Thêm Chiều Thời Gian
Tạo một bức ảnh đòi hỏi hiểu biết về không gian hai chiều. Tạo video khó hơn nhiều, vì mô hình phải giữ cho vật thể nhất quán qua hàng chục, hàng trăm khung hình.
Theo báo cáo kỹ thuật của OpenAI về Sora, mô hình này là một "diffusion transformer": nó kết hợp mô hình khuếch tán với kiến trúc transformer, tương tự nền tảng của các mô hình ngôn ngữ lớn. Video trước hết được nén vào một không gian tiềm ẩn, rồi chia thành các mảnh nhỏ gọi là spacetime patches, mỗi mảnh chứa thông tin về cả không gian lẫn thời gian. Các mảnh này đóng vai trò giống như token trong văn bản. Mô hình khử nhiễu cho nhiều mảnh cùng lúc, nên có thể giữ được sự liên tục của vật thể giữa các khung hình.
- Tính liên tục của vật thể: một chiếc xe đi từ trái sang phải cần giữ nguyên hình dạng và màu sắc qua từng khung hình.
- Hiệu ứng vật lý tương đối thuyết phục: dòng nước, ánh sáng hay vật rơi được mô phỏng khá tự nhiên nhờ việc học từ lượng lớn video thực tế.
Nhưng chính OpenAI cũng thừa nhận mô hình có thể gặp khó với vật lý của các cảnh phức tạp và đôi khi không hiểu đúng quan hệ nhân quả. Nói cách khác, video AI trông thật không đồng nghĩa với việc mô hình thực sự hiểu thế giới vật lý như con người.
Kho Dữ Liệu Huấn Luyện Và Khả Năng Nhận Diện Mẫu Hình
Sức mạnh của các mô hình này đến từ lượng dữ liệu rất lớn mà chúng được học, gồm hàng tỷ hình ảnh, video cùng các mô tả đi kèm. Qua học sâu, mô hình không lưu từng bức ảnh một cách riêng lẻ mà nắm bắt các mẫu hình thống kê: khoảng cách giữa hai mắt, cách ánh sáng phản chiếu trên kim loại, nếp gấp của vải khi chuyển động.
Khi kết hợp các mẫu hình đó, mô hình có thể "sáng tác" những khoảnh khắc chưa từng tồn tại nhưng vẫn hợp lý về mặt thị giác. Các công ty không luôn công bố đầy đủ chi tiết kiến trúc và dữ liệu của sản phẩm thương mại như Midjourney, nên phần mô tả chung ở trên là cách hoạt động phổ biến của các mô hình thuộc nhóm này.
Mặt Trái Và Thách Thức Đạo Đức
Công nghệ này đang thay đổi điện ảnh, thiết kế, quảng cáo và trò chơi điện tử, và giúp giảm đáng kể chi phí sản xuất. Nhưng chúng tôi cũng thấy nó đặt ra nhiều câu hỏi nghiêm túc.
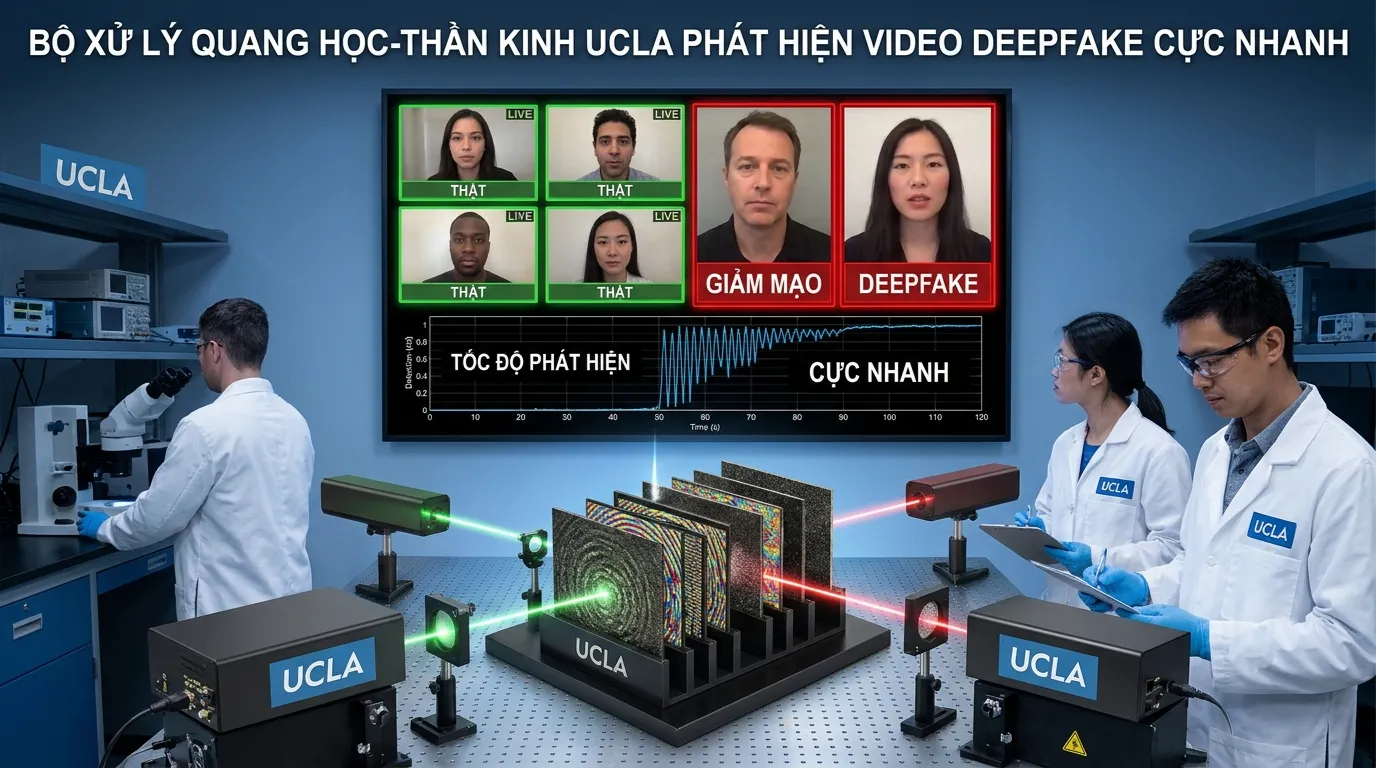
- Tin giả và deepfake: hình ảnh và video giả mạo phát ngôn của chính trị gia, người nổi tiếng hoặc hình ảnh nhạy cảm nhằm bôi nhọ cá nhân có thể được tạo ra dễ dàng hơn trước.
- Bản quyền và sở hữu trí tuệ: việc mô hình học từ tác phẩm của họa sĩ, nhiếp ảnh gia mà chưa chắc có sự cho phép đang gây ra nhiều tranh cãi pháp lý chưa ngã ngũ.
Làm Sao Để Nhận Biết Nội Dung Do AI Tạo?
Không có cách nào chắc chắn tuyệt đối, vì mô hình ngày càng tốt và các dấu hiệu cũ như bàn tay hay chữ viết sai đang dần biến mất. Chúng tôi gợi ý bạn kết hợp nhiều cách.
- Kiểm tra nguồn gốc: xem nội dung do ai đăng đầu tiên và có được cơ quan báo chí uy tín xác nhận hay không.
- Tìm ảnh ngược: dùng công cụ tìm kiếm hình ảnh để xem ảnh có xuất hiện ở nguồn gốc khác với ngữ cảnh khác không.
- Xem thông tin xác thực nội dung: một số công ty, trong đó có OpenAI, cam kết gắn siêu dữ liệu theo chuẩn C2PA, một chuẩn mở dùng để chứng nhận nguồn gốc nội dung. Bạn có thể dùng các trang kiểm tra thông tin xác thực nội dung để xem ảnh hoặc video có mang dấu hiệu này không. Tuy vậy, siêu dữ liệu có thể bị xóa, nên không có dấu cũng chưa chắc là nội dung thật.
- Quan sát chi tiết bất thường: ánh sáng và bóng đổ không khớp, kết cấu nền lạ, vật thể thay đổi hình dạng giữa các khung hình. Đây chỉ là dấu hiệu tham khảo, không đủ để kết luận.
Câu Hỏi Thường Gặp
- AI tạo ảnh bằng cách cắt dán ảnh có sẵn không? Không. Mô hình tạo ảnh mới từ nhiễu ngẫu nhiên, dựa trên các mẫu hình đã học, dù trong một số tình huống kết quả vẫn có thể giống dữ liệu huấn luyện.
- Mô hình khuếch tán là gì? Là loại mô hình học cách khử nhiễu từng bước để biến một ảnh nhiễu thành ảnh rõ nét, được dẫn dắt bởi câu lệnh văn bản.
- GAN khác mô hình khuếch tán thế nào? GAN gồm hai mạng cạnh tranh (tạo ảnh và phân biệt thật giả), còn mô hình khuếch tán tạo ảnh bằng cách khử nhiễu dần. Mô hình khuếch tán thường ổn định hơn khi huấn luyện.
- Sora tạo video bằng công nghệ gì? Theo báo cáo của OpenAI, Sora là mô hình diffusion transformer làm việc trên các mảnh không gian và thời gian của video trong một không gian tiềm ẩn nén.
- Video AI có hiểu vật lý không? Mô hình mô phỏng khá tốt nhiều hiện tượng nhưng vẫn có thể sai ở cảnh phức tạp hoặc quan hệ nhân quả, nên trông thật chưa có nghĩa là hiểu thật.
Kết Luận
AI tạo hình ảnh và video giống thật nhờ sự kết hợp của toán học xác suất, mô hình khuếch tán, các kiến trúc như transformer và kho dữ liệu khổng lồ. Chúng không hiểu thế giới theo cách con người cảm nhận, nhưng có thể tái tạo hiện thực bằng những con số vô cùng tinh vi. Với chúng tôi, điều cần nhớ là khi hình ảnh ngày càng khó phân biệt, thói quen kiểm tra nguồn gốc và hỏi thêm một câu "ai đăng và vì sao" sẽ quan trọng hơn bao giờ hết.
Nguồn tham khảo:
- OpenAI: Video generation models as world simulators
- Ho, J., Jain, A., Abbeel, P., 2020: Denoising Diffusion Probabilistic Models