Rủi Ro Khi Trí Tuệ Nhân Tạo Can Thiệp Đến Sinh Học
Bài viết phát hành:
Cập nhật lần cuối:
AI (trí tuệ nhân tạo) tạo sinh có thể sinh ra dữ liệu sinh học trông rất thật, nhưng cũng có thể bịa ra những chi tiết không tồn tại. Bài viết tóm tắt góc nhìn của nhà khoa học Thomas Burger (CNRS, Pháp) về 10 cách dùng AI tạo sinh trong nghiên cứu omics giúp cho kết quả chuẩn nhất.
Điều Gì Xảy Ra Khi AI "Bịa" Ra Một Dữ Liệu Sinh Học?
Hãy tưởng tượng một nhà nghiên cứu mở bảng kết quả và thấy một hồ sơ biểu hiện gen trông hoàn hảo: số liệu đẹp, phân bố hợp lý, không có gì để nghi ngờ. Chỉ có một vấn đề: nó không đến từ ống nghiệm nào cả. Nó do một mô hình AI tạo sinh "nghĩ" ra, và nó chứa những chi tiết không hề tồn tại ngoài đời thật.
Đó chính là nỗi lo mà Thomas Burger, nhà khoa học cấp cao của CNRS (Pháp), đặt lên bàn trong bài bình luận đăng trên tạp chí Patterns đầu năm 2026. AI tạo sinh (generative AI, hay genAI) đang được kỳ vọng là bước ngoặt cho nghiên cứu omics, nơi việc thu thập dữ liệu vốn bị trói buộc bởi vô số hạn chế thực nghiệm. Nhưng cùng với sức sáng tạo ấy là một bóng ma mang tên "hallucination" (ảo giác), thứ có thể biến một sai sót nhỏ thành hậu quả nặng nề trong sinh học phân tử.
Nguồn ảnh: pispace.io.vn
(Xem thêm: Núi Phú Sĩ (Fuji) Là Núi Lửa Gì? Cập Nhật Mới Nhất 2026)
Vì Sao Giới Omics Lại Khao Khát AI Tạo Sinh Đến Vậy?
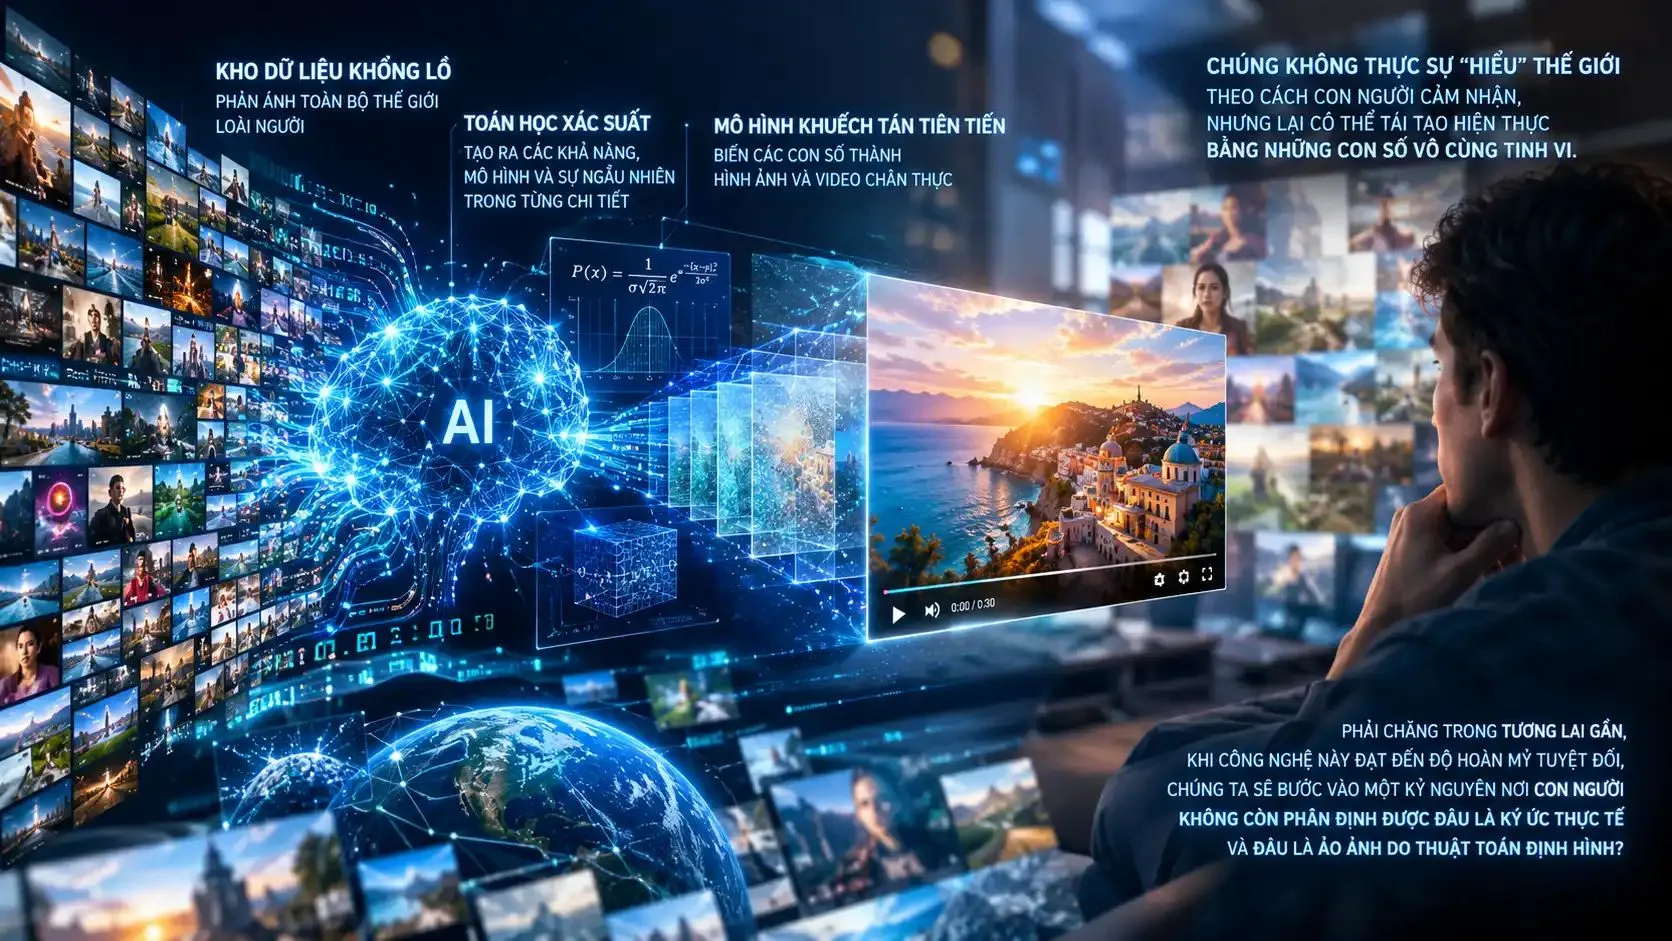
Trong hơn mười năm, các nhà sinh học phân tử đã học cách sống chung với AI dự đoán. Nhưng AI tạo sinh là một câu chuyện khác hẳn. Nó không chỉ phân tích dữ liệu có sẵn mà còn tự tạo ra dữ liệu mới: viết văn bản, nhại giọng nói, dựng ảnh, dựng video, và giờ là cả những hồ sơ dữ liệu sinh học.
Với một phòng lab, viễn cảnh ấy thật quyến rũ. Dữ liệu sinh ra bằng máy có thể giúp bớt đi những con vật thí nghiệm, tiết kiệm chi phí và thời gian, giảm dấu chân môi trường, và còn gợi ý những giả thuyết nghiên cứu mới. Tác giả nhấn mạnh đây mới chỉ là hai trong số nhiều lợi ích.
Ảo Giác Của AI Khác Gì Một Lỗi Dự Đoán Thông Thường?
Đây là chỗ nhiều người dễ hiểu lầm. Một câu trả lời sai của chatbot nghe như một chuỗi dự đoán sai về từ tiếp theo. Nhưng nếu nhìn bằng con mắt toán học, bức tranh khác đi nhiều.
Khi huấn luyện một mô hình học máy thông thường, ta dùng một tập quan sát để khớp một đường xu hướng. Số ràng buộc nhiều hơn số bậc tự do, nên lời giải thường ổn định và duy nhất. Các rủi ro như thiên lệch dữ liệu hay quá khớp đã được nghiên cứu kỹ từ lâu.
Sinh dữ liệu thì ngược lại. Số ràng buộc ít hơn số bậc tự do, và đây là một bài toán "đặt không chỉnh" (ill-posed) khó giải hơn nhiều. Hãy hình dung hai đường cong cùng đi qua đúng những điểm dữ liệu cho trước, nhưng ở giữa các điểm ấy, chúng uốn lượn khác nhau. Chính khoảng trống đó cho mô hình quyền "ứng biến", và cũng là lý do cùng một câu lệnh có thể cho ra nhiều câu trả lời khác nhau. Nếu những đường lượn quá nhỏ, mô hình mất tính sáng tạo. Nếu chúng dao động quá mạnh, sáng tạo biến thành ảo giác: kết quả trông đúng vì khớp các ràng buộc, nhưng chứa những chi tiết phi thực tế.
Nói cách khác, theo tác giả, khả năng ảo giác không phải một lỗi ngẫu nhiên có thể gạt bỏ. Nó gắn liền với chính sự sáng tạo làm nên giá trị của AI tạo sinh. Chỉ là chuyện của mức độ.
Chỉnh "Temperature" Có Đủ Để Kiểm Soát Ảo Giác Không?
Nhiều người tin rằng chỉ cần xoay nút "temperature" của mô hình ngôn ngữ lớn là điều khiển được độ sáng tạo. Thực tế phũ phàng hơn. Tham số này khó chỉnh cho đúng, và các phân tích mới cho thấy mối liên hệ của nó với sáng tạo yếu hơn người ta vẫn tưởng. Hướng "tạo văn bản có dẫn nguồn" (retrieval-augmented generation) ra đời cũng chính vì mô hình có thể bịa cả sự kiện lẫn tài liệu tham khảo.
Vì Sao Ảo Giác Trong Dữ Liệu Sinh Học Nguy Hiểm Hơn Ảo Giác Trong Văn Bản?
Với văn bản và ảnh đời thường, mắt người khá tinh. Một bức ảnh có bàn tay thừa ngón thì khó đánh lừa được ai. Nhưng ngay khi chuyển sang ảnh kỹ thuật như mô bệnh học hay nhuộm miễn dịch, việc phát hiện đã khó hơn nhiều. Với dữ liệu omics thì còn khó hơn nữa.
Burger cảnh báo rằng ta không nên mặc định bất kỳ chuyên gia nào cũng dễ dàng phân biệt một hồ sơ omics bị ảo giác nhẹ với một hồ sơ do AI tạo ra tuy lạ nhưng vẫn thực tế. Mà vì sinh học phân tử là lĩnh vực hiểu biết của chúng ta còn bị thử thách hằng ngày, ranh giới giữa "lạ nhưng đúng" và "lạ vì sai" càng mờ.
Vậy Có Nên Từ Bỏ AI Tạo Sinh Trong Omics Không?
Không, và tác giả nói rất rõ điều đó. Ông không ủng hộ việc quay lưng với những tiềm năng tích cực của công nghệ này. Điều ông đề xuất là một câu hỏi thực dụng, đặt theo kiểu "tính cho tình huống xấu nhất": dùng công cụ AI thế nào để nếu nó tạo ra một ảo giác mà không ai phát hiện, hậu quả cũng không biến thành một phát hiện sinh học sai? Ông ví phát hiện sai ấy như "tin giả" của thế giới khoa học.
Từ câu hỏi đó, ông liệt kê mười tình huống sử dụng, chia làm ba nhóm.
Nhóm 1: Khi AI Chỉ Làm Nhiệm Vụ Gợi Ý Giả Thuyết, Rủi Ro Nằm Ở Đâu?
Ở nhóm này, dữ liệu AI sinh ra không phải đích đến. Nó chỉ là bước đệm để con người nghĩ ra giả thuyết, và giả thuyết nào cũng phải được kiểm chứng. Nếu AI ảo giác, giả thuyết sinh ra sẽ viển vông, nhưng theo tác giả điều đó không tệ hơn trực giác sai của một sinh viên chưa vững hay dữ liệu từ một bài báo bị rút lại sau này. Điều tệ nhất có thể xảy ra là nhà nghiên cứu mất thời gian và tiền bạc thử những giả thuyết vô nghĩa, chứ không phải đưa ra kết luận sinh học sai.
1. Sàng Lọc Sơ Bộ: Loại Bớt Trước Khi Tốn Công Thử
Đây là ứng dụng quen thuộc nhất, điển hình là thiết kế protein và khám phá thuốc với những công cụ như AlphaFold. Thay vì đem thử vô số chuỗi protein, người ta loại sớm những chuỗi có cấu trúc 3D khó khớp, rồi chỉ kiểm tra các ứng viên còn lại trong ống nghiệm và trên sinh vật sống. Phần được lợi rất lớn, còn phần thiệt chỉ là vài ứng viên bị loại nhầm, một rủi ro vốn đã tồn tại từ trước.
2. Bản Sao Số: Thử Nghiệm Ảo Trước Khi Chạm Vào Thiết Bị Thật
"Digital twin" là bản mô phỏng số độ chính xác cao của một quy trình thực, chạy theo thời gian thực và tái hiện cả vòng đời, kể cả quá trình lão hóa. Vì thế, nó chưa hợp với sinh vật phức tạp, nhưng rất lý tưởng cho các hệ thống công nghệ sinh học như lò phản ứng sinh học. genAI có thể mô phỏng ảnh hưởng của những điều chỉnh nhỏ lên các tham số, để tìm cấu hình tốt hơn hoặc kiểm tra xem một xáo trộn nhỏ có đẩy hệ thống vào trạng thái bất ổn không. Ảo giác có thể làm kết quả xấu đi, nhưng một chuyên gia tỉnh táo hoàn toàn có thể chặn lại nếu chỉ dùng AI để sàng lọc.
3. Phân Tích Phản Thực: Trả Lời Câu Hỏi "Nếu Như..."
Có những câu hỏi không bao giờ thử được ngoài đời. Nếu bệnh nhân số 12345 không qua đời vì tai nạn giữa thử nghiệm, liệu thuốc có chữa khỏi cho bà ấy không? Phân tích phản thực vốn là một ngành thống kê lâu đời, nay hồi sinh nhờ nhu cầu giải thích các dự đoán của học sâu. genAI cho phép sinh hàng loạt dữ liệu tương tự với những thay đổi rất nhỏ, rồi từ đó chắt lọc vài giải thích đáng điều tra kỹ. Hướng này gắn với khái niệm "mô hình nhiễu loạn lớn", và có thể định hình cách nghiên cứu hàn lâm khai thác AI trong tương lai.
Nhóm 2: Khi Dữ Liệu AI Tạo Ra Đi Thẳng Vào Phép Thống Kê, Làm Sao Đảm Bảo An Toàn?
Đây là nhóm đáng lo hơn, vì dữ liệu nhân tạo được dùng trực tiếp để rút ra kết luận sinh học. Tuy vậy, Burger chỉ ra ba tình huống mà ảo giác vẫn có "van an toàn" tự nhiên.
1. Dữ Liệu Cho Giả Thuyết Không: Khi Ảo Giác Chỉ Làm Bài Kiểm Tra Khó Đạt Hơn
Trong thống kê, "dữ liệu null" là những phép đo bình thường, không đủ để nói có điều gì đáng chú ý. Với dữ liệu sinh học phức tạp, nhiều khi không có sẵn mô hình toán học cho dữ liệu này, nên người ta dựa vào mô hình null thực nghiệm. Ví dụ là hoán vị ngẫu nhiên giữa các mẫu khi phân tích biểu hiện gen, hay tạo các cặp phổ-chuỗi ngẫu nhiên ("decoy") để đánh giá độ tin cậy khi nhận diện peptide trong proteomics khối phổ. Cách này còn giúp tránh lỗi "double-dipping" trong dữ liệu đơn bào.
Điều đáng mừng là ở đây có sẵn một cơ chế bảo vệ. Vì dữ liệu chỉ được tạo theo giả thuyết không, nếu dữ liệu không bị lệch rõ rệt, thì ảo giác nhiều hơn chủ yếu làm dữ liệu đa dạng hơn. Hệ quả là sức mạnh thống kê giảm, chứ không phải kết quả dương tính giả tăng.
2. Dữ Liệu Đối Chứng Âm: Khai Thác Kho Mẫu Đối Chứng Khổng Lồ
Mẫu đối chứng, như người khỏe mạnh hay mẫu kiểu dại, thường được dùng lại giữa nhiều thí nghiệm, dù điều kiện thử nghiệm luôn thay đổi. Vì vậy, có lý khi dùng kho dữ liệu đối chứng đã có để huấn luyện mô hình sinh ra các hồ sơ đối chứng mới. Cách tiếp cận này chưa thực sự bùng nổ trong omics, nhưng những công cụ như Evo 2, vốn sinh được dữ liệu bộ gen khá thực tế, đang dần xuất hiện. Có thể trong tương lai gần, chúng đủ chính xác để tạo mẫu đối chứng dùng so sánh với mẫu thử nghiệm.
3. Chỉnh Sửa Dữ Liệu Mà Vẫn Giữ Được "Linh Hồn" Của Nó
Ở đây, genAI được dùng để biến đổi dữ liệu có sẵn thay vì tạo từ đầu, với ba mục đích chính:
- Bảo vệ quyền riêng tư: ngay cả khi tên bệnh nhân đã được thay bằng mã số, tổ hợp đặc điểm lâm sàng và di truyền riêng biệt vẫn có thể giúp kẻ xấu nhận diện lại. Giải pháp là chỉnh dữ liệu đủ để không thể truy ra danh tính, nhưng đủ nhỏ để phân bố tổng thể không đổi và vẫn phân tích thống kê được.
- Thích nghi miền: chuyển dữ liệu sang một bối cảnh mới, nơi dữ liệu thật khó thu thập.
- Điền giá trị thiếu: thay vì bỏ những mẫu không đầy đủ, ta bổ sung cho đủ mà không làm hỏng phân tích phía sau. genAI đã được ghi nhận là bổ sung có giá trị cho dữ liệu phiên mã đơn bào.
Với cả ba nhóm này, cách giảm rủi ro nằm ở việc dùng sức sáng tạo của AI để làm phong phú thêm dữ liệu tham chiếu. Khi đó, nếu ảo giác đi quá đà, các mẫu ở ranh giới sẽ trông giống mẫu bình thường hơn, thay vì bị nhầm thành phát hiện mới.
Nhóm 3: Khi AI Giúp Phát Triển Phương Pháp, Nhà Sinh Học Có Phải Lo Ảo Giác Không?
Nhóm cuối cùng nhìn về tương lai, khi genAI đã trở thành công cụ quen thuộc của omics. Thực nghiệm vẫn sẽ là tiêu chuẩn vàng trong một thời gian nữa, nhưng đã có những tình huống mà dữ liệu sinh ra có thể thay thế được, nhất là khi phát triển và tinh chỉnh các phương pháp tin sinh học mới.
1. Mô Phỏng Quy Mô Lớn
Khi dữ liệu tạo ra rẻ hơn, dễ tiếp cận hơn và thực tế hơn, hàng loạt công việc trở nên dễ dàng: đánh giá chuẩn, kiểm chứng với dữ liệu có "sự thật nền", stress test, phân tích độ nhạy. Các mô hình học máy cũng nhờ đó trở nên bền vững hơn.
2. Bootstrapping
Kỹ thuật này dùng chính các điểm dữ liệu gốc để ước lượng một phân phối, rồi sinh thêm mẫu mới từ phân phối đó. Nghe như trò ảo thuật tự nhấc mình lên bằng dây giày của chính mình, nhưng tính đúng đắn thống kê phụ thuộc vào cách tạo ra dữ liệu mới.
3. Tăng Cường Dữ Liệu
Các mô hình học sâu vốn "đói" dữ liệu huấn luyện. Thêm dữ liệu nhân tạo, hoặc tạo nhiều phiên bản biến đổi cho từng mẫu, giúp mô hình khái quát tốt hơn. Thậm chí, huấn luyện trên dữ liệu sinh ra, nơi các thiên lệch của quá trình thu thập đã được giảm bớt, còn có thể cải thiện thêm khả năng tổng quát hóa.
4. Lưu Trữ Bằng Mô Hình Thay Vì Lưu Dữ Liệu
Đây có lẽ là viễn cảnh táo bạo nhất. Theo ý tưởng được giáo sư Efros đề xuất, một ngày nào đó genAI đủ phổ biến và đáng tin để thay thế việc lưu trữ. Thay vì giữ những khối dữ liệu thực nghiệm khổng lồ, tốn bộ nhớ và năng lượng, ta chỉ cần lưu một mô hình đã học từ chúng, rồi tái tạo lại khi cần, với chút biến thiên ngẫu nhiên.
Ở nhóm này, genAI tham gia vào việc phát triển phần mềm tin sinh học, như bất kỳ đột phá lý thuyết nào trong toán học hay khoa học máy tính. Vì vậy, gánh nặng ảo giác không đặt lên vai nhà sinh học. Họ chỉ cần giữ con mắt phê phán như mỗi khi đưa một công cụ học máy mới vào quy trình làm việc.
Câu Hỏi Thường Gặp Về AI Tạo Sinh Trong Omics
AI Tạo Sinh Trong Omics Là Gì?
Đó là việc dùng các mô hình AI có thể tạo ra dữ liệu mới, như hồ sơ biểu hiện gen, chuỗi protein hay dữ liệu đối chứng, dựa trên những gì chúng đã học từ dữ liệu có sẵn, thay vì chỉ phân tích hay dự đoán.
"Hallucination" Của AI Nghĩa Là Gì?
Đó là khi AI tạo ra dữ liệu hoặc nội dung trông hợp lý nhưng chứa chi tiết phi thực tế, vì mô hình sáng tạo quá mức. Theo bài viết, khả năng này gắn liền với chính sự sáng tạo của genAI.
Ảo Giác Khác Lỗi Dự Đoán Của Học Máy Truyền Thống Ở Điểm Nào?
Dự đoán là bài toán có số ràng buộc nhiều hơn số bậc tự do nên kết quả thường duy nhất. Sinh dữ liệu là bài toán thiếu ràng buộc, nên có nhiều lời giải cùng hợp lệ, và ranh giới giữa sáng tạo với ảo giác trở nên mờ.
Chuyên Gia Có Dễ Nhận Ra Dữ Liệu Omics Bị Ảo Giác Không?
Không hẳn. Tác giả lưu ý rằng ta không nên cho rằng một chuyên gia dễ dàng phân biệt hồ sơ omics bị ảo giác nhẹ với một hồ sơ lạ nhưng thực tế do AI tạo ra.
Nên Dùng AI Tạo Sinh Theo Cách Nào Để An Toàn?
Bài viết đề xuất chọn những cách dùng mà nếu ảo giác không bị phát hiện, nó cũng không dẫn tới phát hiện sinh học sai. Mười tình huống được nêu gồm: sàng lọc sơ bộ, tối ưu bằng bản sao số, phân tích phản thực, sinh dữ liệu giả thuyết không, sinh dữ liệu đối chứng âm, chỉnh sửa dữ liệu giữ nguyên biến thiên, mô phỏng quy mô lớn, bootstrapping, tăng cường dữ liệu và lưu trữ dữ liệu.
Dữ Liệu Do AI Tạo Ra Có Thay Thế Hoàn Toàn Thực Nghiệm Được Không?
Chưa. Theo tác giả, thực nghiệm vẫn là tiêu chuẩn vàng trong một thời gian nữa. Dữ liệu sinh ra chỉ thay thế được ở những tình huống cụ thể, nhất là khi phát triển và tinh chỉnh phương pháp tin sinh học.
Danh Sách Mười Tình Huống Này Đã Đầy Đủ Chưa?
Chưa. Tác giả cho rằng danh sách còn mở và kỳ vọng sẽ có thêm các cách dùng "an toàn" xuất hiện trong y văn thời gian tới.
Giải Thích Nhanh Các Thuật Ngữ Khoa Học Trong Bài
- Omics: Tên gọi chung của các ngành nghiên cứu toàn bộ một nhóm phân tử trong tế bào cùng lúc, như bộ gen, protein hay các bản phiên mã. Generative AI (AI tạo sinh): AI có thể tạo ra nội dung mới như văn bản, hình ảnh hay dữ liệu, thay vì chỉ phân loại hay dự đoán.
- Hallucination (ảo giác AI): Khi AI tạo ra thông tin trông rất hợp lý nhưng thực ra sai hoặc không có thật.
- Overfitting (quá khớp): Khi mô hình học thuộc cả những chi tiết ngẫu nhiên của dữ liệu huấn luyện, nên hoạt động kém trên dữ liệu mới.
- Ill-posed problem (bài toán đặt không chỉnh): Bài toán có quá ít ràng buộc nên có nhiều đáp án cùng đúng. Việc sinh dữ liệu thuộc loại này.
- Null hypothesis (giả thuyết không): Giả định mặc định rằng "không có gì đặc biệt xảy ra". Chỉ khi dữ liệu mâu thuẫn rõ với giả định này, nhà nghiên cứu mới tuyên bố có phát hiện.
- False positive (dương tính giả): Kết luận có phát hiện trong khi thực tế không có, tức "báo động nhầm".
- Negative control (đối chứng âm): Mẫu mà ta biết trước là không có thay đổi, như người khỏe hay mẫu kiểu dại, dùng làm chuẩn để so sánh.
- Prescreening (sàng lọc sơ bộ): Dùng AI loại bớt các ứng viên kém triển vọng trước, để chỉ thử nghiệm thật trên số ít còn lại.
- Digital twin (bản sao số): Mô hình mô phỏng số chính xác của một hệ thống thật, chạy theo thời gian thực để thử nghiệm mà không đụng đến hệ thống thật.
- Counterfactual analysis (phân tích phản thực): Trả lời câu hỏi "điều gì sẽ xảy ra nếu mọi thứ khác đi?", ví dụ nếu bệnh nhân dùng thuốc khác thì kết quả ra sao.
- Bootstrapping: Kỹ thuật lấy mẫu lại nhiều lần từ chính dữ liệu gốc để ước lượng độ tin cậy của kết quả.
- Data augmentation (tăng cường dữ liệu): Tạo thêm dữ liệu huấn luyện bằng cách biến đổi dữ liệu có sẵn hoặc thêm dữ liệu nhân tạo.
Kết Luận: Rốt Cuộc, Nên Dùng AI Tạo Sinh Thế Nào Cho Đúng?
Như mọi bước đột phá công nghệ, AI tạo sinh sẽ dần lan rộng khi các nhà nghiên cứu hiểu và kiểm soát được nó. Điều Thomas Burger muốn nhắn nhủ không phải là sợ hãi hay né tránh, mà là sự tỉnh táo: chọn những bối cảnh mà dù ảo giác có lọt qua, hậu quả cũng không trở thành một "tin giả" của khoa học.
Hy vọng của ông rất giản dị. Rồi sẽ đến ngày giới nghiên cứu nhìn dữ liệu do AI sinh ra bằng đúng con mắt phê phán dành cho dữ liệu thực nghiệm, để nó trở thành một phần tự nhiên của phương pháp khoa học, chứ không phải một nguồn rủi ro âm thầm.
Nguồn tham khảo:
Keeping generative artificial intelligence reliable in omics biology
Tác giả: Thomas Burger (nhà khoa học cấp cao của CNRS)
Đơn vị: University Grenoble Alpes, CNRS, CEA, INSERM, UA13 BGE, UAR2048 ProFI, EDyP, 38000 Grenoble, Pháp
Liên hệ: thomas.burger@cea.fr
Tạp chí: Patterns (Cell Press), tập 7, ngày 9/1/2026, trang 1-5
DOI: 10.1016/j.patter.2025.101417
Giấy phép: Truy cập mở (Open Access), CC BY 4.0, bản quyền © 2025 The Author(s), do Elsevier Inc. xuất bản
Xung đột lợi ích: Tác giả khai báo không có.
Tài trợ: Cơ quan Nghiên cứu Quốc gia Pháp (ANR), gồm các dự án ProFI (ANR-10INBS-0008), GRAL CBH (ANR-17-EURE-0003), France 2030 (ANR-19-P3IA-0003), PeptidOMS (ANR-24-CE45-3296) và ProteoVir (ANR-24-RRII-0001).
Tác giả cảm ơn những người tổ chức hội thảo Lorentz 2025 về phương pháp AI cho proteomics (Magnus Palmblad, Robbin Bouwmeester, Lukas Käll), cùng Frédéric Bertrand, Oscar Vassalo, Marina Pominova và các phản biện ẩn danh.